Большинство современных нейросетей отлично работает с английским и несколькими десятками крупных языков. Но в мире существует около 7 000 языков, и значительная их часть практически не представлена в данных, на которых обучают искусственный интеллект.
Теперь эту проблему решили попробовать исправить сразу десятки организаций. Google, Anthropic, Microsoft, Mistral, OpenAI Foundation и другие участники объявили о совместной инициативе, цель которой — сделать ИИ доступным на языках, которые сегодня он понимает плохо или почти не понимает.
Главное:
60 организаций объединились в инициативу
3,4 млрд человек могут получить доступ к ИИ на своём языке
5 лет — срок, за который участники хотят добиться заметного прогресса
Почему искусственный интеллект знает не все языки
Нейросеть не изучает язык так, как человек. Для обучения ей требуется огромное количество текстов, аудиозаписей и других примеров реального использования языка.
С английским проблем практически нет: книг, сайтов, документов, социальных сетей и разговорных записей существует огромное количество.
А вот для многих языков Африки, Азии и других регионов цифровых материалов значительно меньше.
Причём даже поддерживаемые языки нейросети могут понимать неодинаково — это показало недавнее исследование работы ИИ на разных языках.
В результате человек может свободно говорить на своём родном языке, но нейросеть будет плохо распознавать его речь, допускать ошибки в переводе или вообще не поддерживать этот язык.
Что хотят сделать Google, Anthropic и другие участники
Новая инициатива должна объединить работу компаний, исследователей, университетов и местных языковых сообществ.
Главная задача — создать больше качественных данных для языков, которые сегодня недостаточно представлены в искусственном интеллекте.
Работа пойдёт сразу по четырём направлениям:
— создание открытых языковых баз данных;
— разработка тестов для проверки качества ИИ;
— создание моделей и приложений на основе этих данных;
— защита конфиденциальности и прав носителей языков.
Особое внимание планируют уделять не только письменному тексту, но и человеческой речи.
Почему голос иногда важнее текста
Для многих языков именно устная речь остаётся основной формой общения.
Человек может прекрасно владеть своим языком, но редко использовать его в письменной форме. Кроме того, некоторые языки имеют несколько вариантов письменности или сравнительно небольшое количество опубликованных текстов.
Поэтому для развития ИИ нужны не только книги и сайты, но и записи обычных разговоров.
Такие данные помогают системе научиться понимать произношение, акценты, диалекты, местные выражения и естественную скорость речи.
Почему недостаточно просто перевести всё с английского
Самый простой вариант — взять английский текст и автоматически перевести его на другой язык.
Но такой подход не решает проблему полностью.
Язык содержит собственные выражения, шутки, способы обращения к людям и культурные особенности. Если обучать нейросеть преимущественно переводным текстам, она может формально знать слова, но плохо понимать то, как люди действительно разговаривают.
Какие компании участвуют в проекте
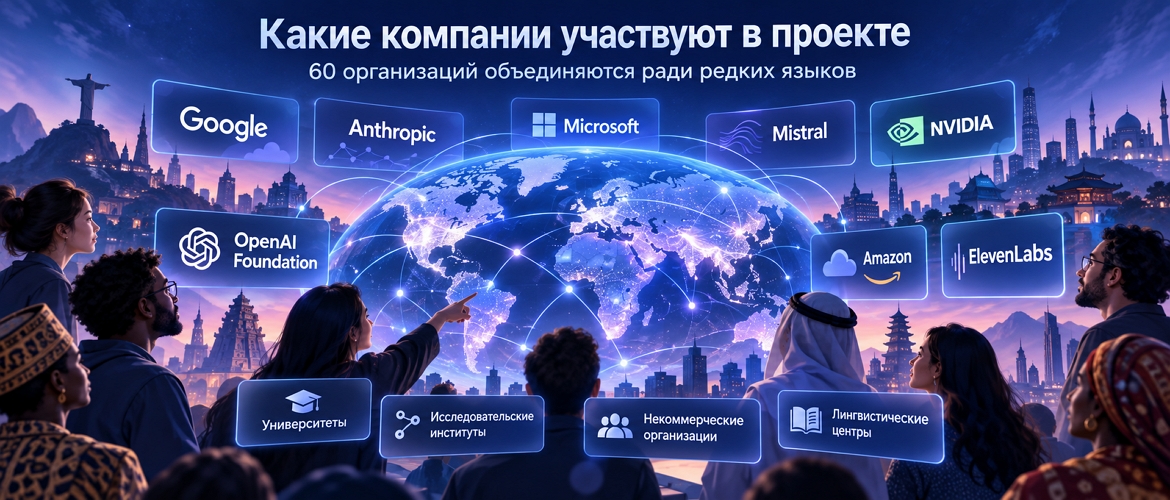
Список участников довольно необычный, потому что вместе оказались компании, которые обычно конкурируют между собой.
Среди них Google, Anthropic, Microsoft, Mistral, NVIDIA, OpenAI Foundation, Amazon, ElevenLabs и десятки исследовательских, образовательных и общественных организаций.
Всего на старте инициативу поддержали 60 участников.
При этом они не создают одну общую нейросеть. Каждый участник будет заниматься своей частью работы: кто-то собирать языковые данные, кто-то создавать модели, кто-то тестировать их, а кто-то работать непосредственно с носителями языков.
Зачем ИИ нужны редкие языки
Проблема касается далеко не только обычного общения с чат-ботом.
Если искусственный интеллект понимает язык человека, он потенциально может помочь получить образовательные материалы, медицинскую информацию, консультации для сельского хозяйства или доступ к государственным и финансовым сервисам.
Но если система плохо понимает вопрос, польза от такого инструмента резко уменьшается.
Именно поэтому участники инициативы говорят не просто о переводе интерфейса, а о способности ИИ действительно понимать язык и речь человека.
Сможет ли ИИ когда-нибудь понимать все языки мира
Это гораздо более сложная задача, чем может показаться.
Некоторыми языками пользуются сотни миллионов человек, другими — несколько тысяч или даже несколько сотен.
Для части языков мало цифровых текстов, а для некоторых практически отсутствуют качественные записи речи.
Кроме того, язык постоянно меняется: появляются новые слова, сленг и местные варианты произношения.
Поэтому обещать, что через пять лет нейросети идеально заговорят на всех семи тысячах языков, было бы неправильно.
Но направление уже понятно: следующий этап развития искусственного интеллекта — не просто увеличение количества поддерживаемых языков, а улучшение качества работы с теми языками, которые раньше технологии почти игнорировали.